Das Wichtigste in Kürze
- Connectoren lösen das Zugriffsproblem, nicht das Aktualitätsproblem: Ein Agent, der veraltetes Wissen findet, gibt veraltete Antworten.
- Wissen fließt den Weg des geringsten Widerstands – ins Gespräch, nicht in die Doku. Dokumentationspflichten versanden.
- Ein Agent fängt Wissen im Team-Chat auf und legt es in Git ab, mit Metadaten zu Quelle, Prüfer:in und Ablaufdatum.
- Wissen wird anlassbezogen aufgebaut und per Pull Request kuratiert – nicht als Massenimport aus dem Wiki.
Kontext lebt an vielen Orten
Fragt man einen Coding Agent, wie der Payment-Retry funktioniert, steckt die Antwort selten an einer Stelle. Ein Teil steht im Wiki von 2021, ein Teil in einem Ticket, ein Teil im Code, die aktuelle Entscheidung in einem Chat-Thread von letzter Woche – und der Rest in den Köpfen der Menschen, die das System gebaut haben.
Für Menschen ist das lästig. Für AI Agents ist es ein grundlegendes Problem: Sie arbeiten mit dem Kontext, den sie bekommen. Fehlt das entscheidende Stück oder widersprechen sich die Quellen, rät der Agent – überzeugend formuliert und schwer zu erkennen.
Connectoren binden alles an – auch das Veraltete
Der naheliegende Schritt ist, dem Agenten Zugriff auf alle Quellen zu geben: Connectoren für Wiki, Drive, Ticketsystem und Chat. Damit ist das Wissen erreichbar. Richtig ist es dadurch nicht.
Der größte Teil dessen, was in diesen Systemen liegt, ist Jahre alt und wurde nie aktualisiert. Niemand weiß, welche Seite noch gilt. Der Agent kann es auch nicht wissen. Je mehr Quellen angebunden sind, desto wahrscheinlicher landet ein veraltetes Dokument im Kontext und bestimmt die Antwort.
Wissen fließt wie Wasser
Menschen folgen dem Weg des geringsten Widerstands. Wissen entsteht im Gespräch, im Pairing, im Chat und bleibt dort. Der Weg bergauf in die Dokumentation ist mühsam, also wird er selten gegangen.
Eine Dokumentationspflicht hilft für kurze Zeit. Nach ein paar Wochen versandet die Disziplin, und die Doku veraltet wieder. Das ist kein Charakterproblem des Teams, sondern ein Prozessproblem: Der Prozess verlangt Arbeit an der falschen Stelle.
Der Ansatz im Agentic SDLC dreht das um. Ein Wissens-Agent fängt das Wissen dort auf, wo ohnehin geredet wird, und baut daraus eine verknüpfte Wissensbasis. Das Team muss nichts zusätzlich tun, außer zu prüfen, was der Agent vorschlägt.
Git als System of Record
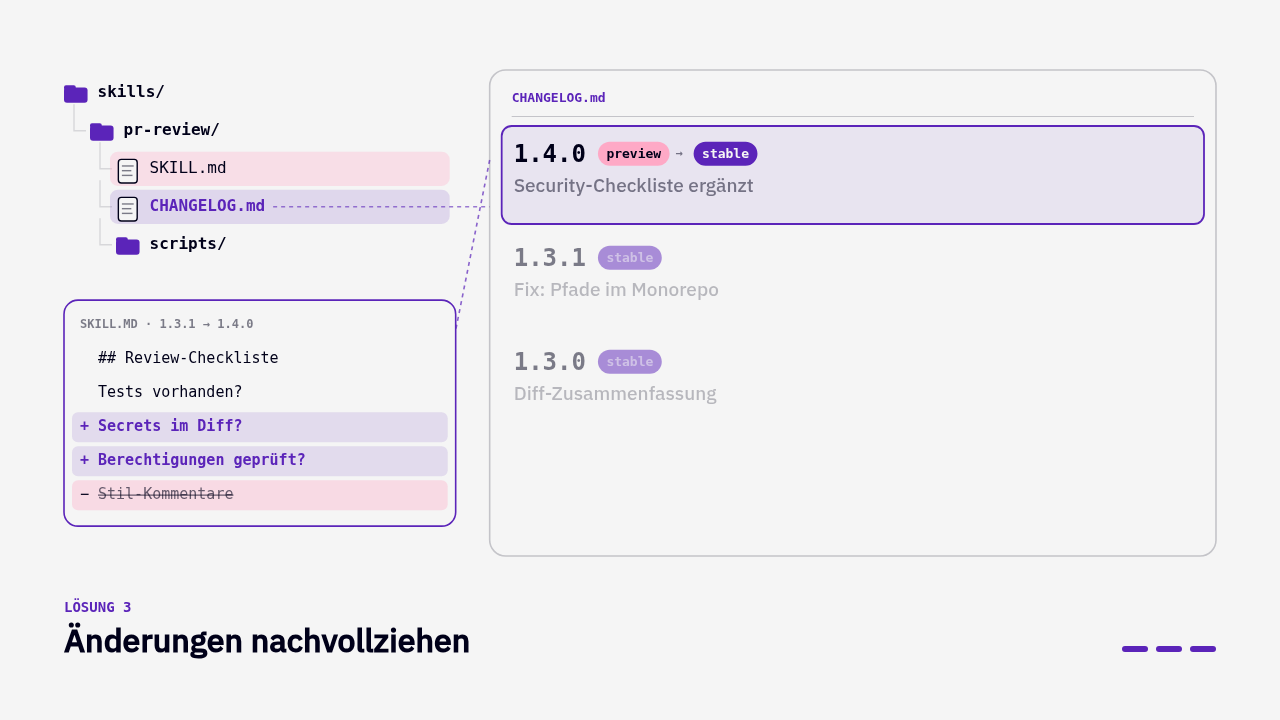
Die Wissensbasis liegt als Markdown in einem Git-Repository. Jedes Wissensstück ist eine Datei, jede Änderung ein Commit. Damit gelten für Wissen dieselben Werkzeuge wie für Code: Historie, Diff, Review und Rechte.
Damit Menschen und Agenten erkennen, wie belastbar ein Stück Wissen ist, trägt jede Datei Metadaten im Frontmatter, etwa im Open Knowledge Format (OKF):
- sources: Woher das Wissen stammt, zum Beispiel ein Chat-Kanal oder ein Pull Request.
- generated: Wer den Eintrag erstellt hat, etwa der Wissens-Agent.
- verified: Welcher Mensch den Inhalt geprüft hat.
- status: Ob der Eintrag ein Entwurf ist oder als stabil gilt.
- stale_after: Ab wann der Eintrag erneut geprüft werden muss. Aktualität wird so an jeder Datei sichtbar.
Der Agent fragt nach, ein Mensch ist accountable
Läuft ein Wissensstück ab, wartet der Agent nicht, bis jemand es bemerkt. Er fragt im Team-Chat direkt die verantwortliche Person, ob der Inhalt noch stimmt – etwa ob die Refund-Frist noch 14 Tage beträgt.
Die Korrektur kommt im Thread, so wie das Team ohnehin arbeitet. Der Agent übernimmt sie in einen Pull Request, aktualisiert Prüfer:in und Ablaufdatum, und die verantwortliche Person mergt. Der Merge ist die Kuration: Jede Änderung an der Wissensbasis ist explizit von einem Menschen freigegeben.
Bottom-up statt Massenimport
Ein verbreitetes Anti-Pattern ist, zum Start 3.000 Dokumente aus dem Wiki zu importieren und sie anschließend durchzugehen. Das Review stockt nach wenigen Dutzend Dokumenten, der Rest bleibt ungeprüft und veraltet weiter – jetzt nur an einem neuen Ort.
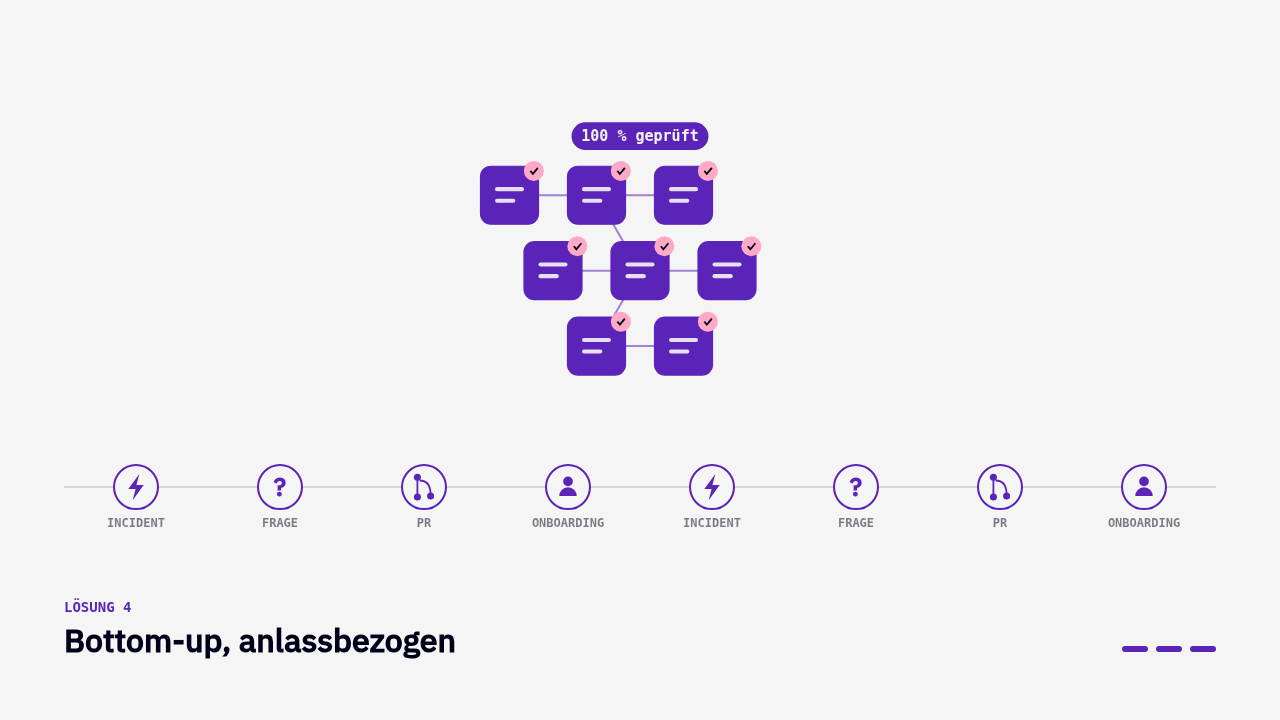
Besser funktioniert ein anlassbezogener Aufbau. Jeder Anlass erzeugt genau ein geprüftes Wissensstück:
- ein Incident und seine Ursache,
- eine Frage, die im Team-Chat beantwortet wird,
- ein Pull Request mit einer Architekturentscheidung,
- ein Onboarding, bei dem Lücken auffallen.
Was das für Engineering-Teams bedeutet
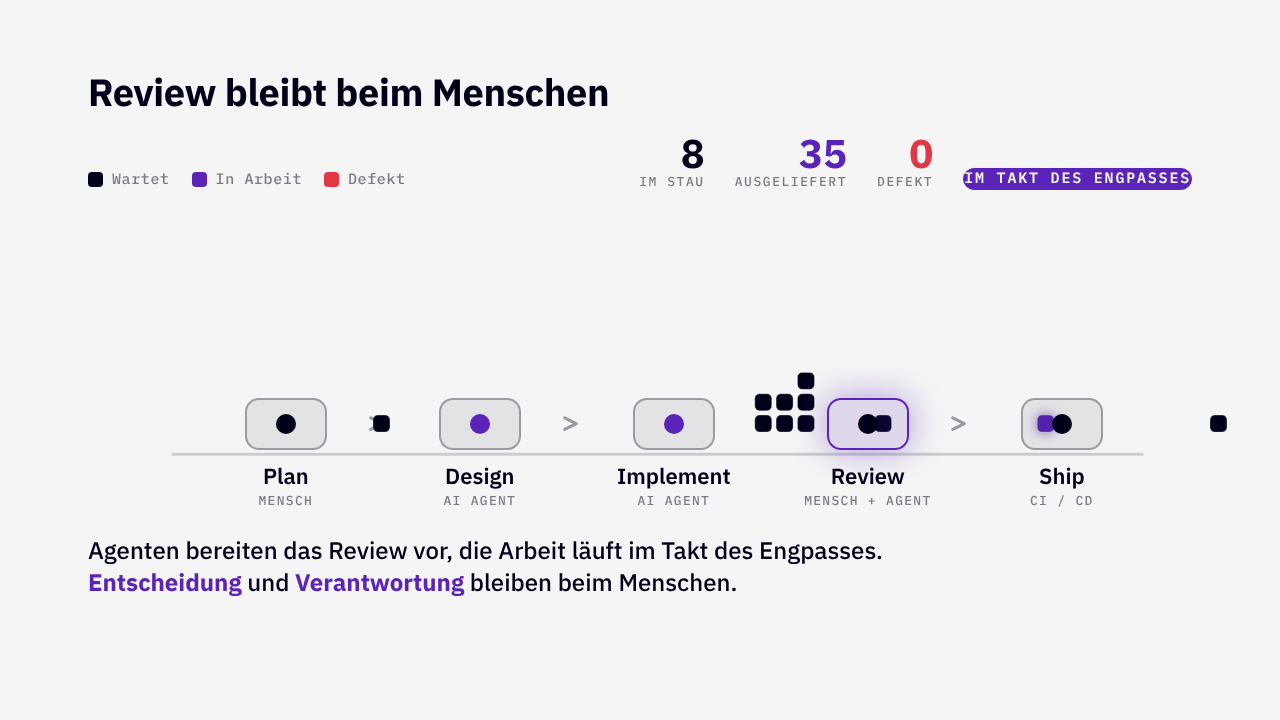
Kontextmanagement ist kein Tool, das man einmal einführt, sondern ein Kreislauf: Wissen auffangen, versionieren, prüfen, ablaufen lassen, erneut prüfen. Agenten übernehmen dabei die lästige Arbeit, Menschen behalten die Verantwortung für die Inhalte.
Die Wissensbasis wächst langsamer als ein Massenimport, ist aber zu jedem Zeitpunkt vollständig geprüft. Genau das brauchen AI Agents, um im Software Development Lifecycle verlässlich zu arbeiten.